Un rapport Search Console qui affiche 516 pages non indexées contre 369 pages indexées, ça fait peur. Certains prestataires s’en servent d’ailleurs pour vendre des audits à plusieurs milliers d’euros. Pourtant, dans la grande majorité des cas, ce chiffre ne dit presque rien de la santé de votre site.
Une page non indexée n’est pas forcément un problème. Google écarte chaque jour des URL qui n’ont jamais eu vocation à apparaître dans ses résultats : des variantes avec paramètres, des copies, des redirections. Ce guide vous montre comment lire ce rapport motif par motif, comment trier vos URL en deux minutes avec une IA, et comment repérer les rares cas qui méritent vraiment une action.
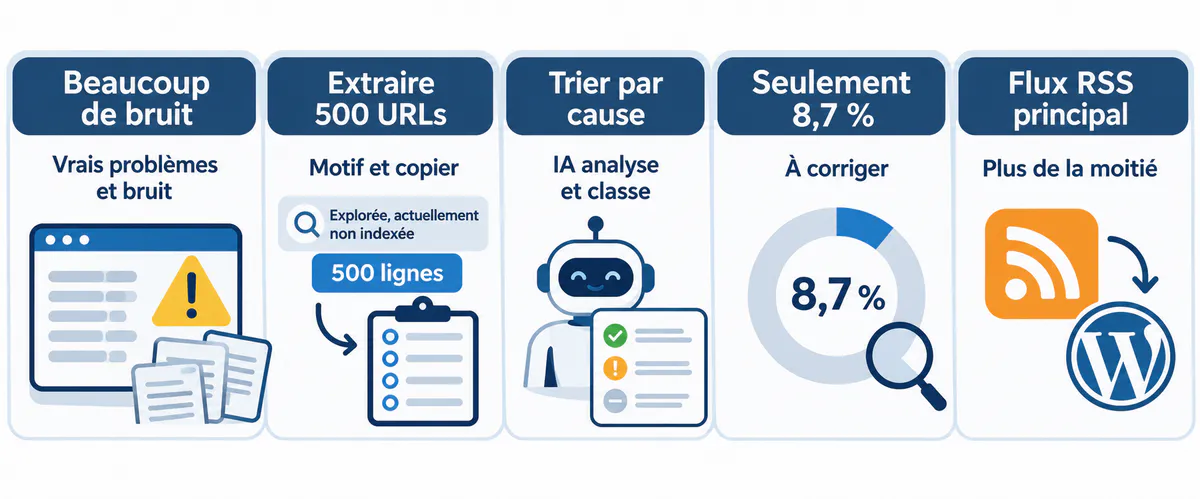
La réponse courte. Le compteur « pages non indexées » mélange du bruit et de vrais signaux. Sur un site réel de 885 URL connues, le tri a montré que seules 8,7 % des URL du motif « Explorée, actuellement non indexée » demandaient une action. Plus de la moitié venaient d’une seule source : les liens du flux RSS de WordPress, recopiés ailleurs avec des paramètres de suivi.
Où se cache ce chiffre dans Search Console
Ouvrez Google Search Console, puis le menu Indexation et la rubrique Pages. Le graphique du haut affiche deux compteurs : les pages indexées en vert et les pages non indexées en gris. C’est ce second chiffre qu’on vous montre pour vous inquiéter.
Le vrai contenu du rapport se trouve plus bas, dans le tableau « Pourquoi les pages ne sont pas indexées ». Chaque ligne correspond à un motif. Et chaque motif n’a pas du tout la même gravité.
Les motifs de non-indexation, et ce qu'ils signifient vraiment
| Motif affiché | Ce que ça veut dire | Faut-il agir ? |
|---|---|---|
| Explorée, actuellement non indexée | Google a visité l’URL mais ne l’a pas retenue : variante inutile ou contenu jugé trop faible. | Trier : la plupart sont du bruit, quelques-unes sont de vraies pages à retravailler. |
| Détectée, actuellement non indexée | Google connaît l’URL mais ne l’a pas encore explorée. | Oui si ce sont des pages importantes : renforcer les liens internes et le sitemap. |
| Autre page avec balise canonique correcte | C’est une copie qui désigne bien la page originale. | Non, c’est le fonctionnement normal. |
| Page en double sans URL canonique sélectionnée par l’utilisateur | Plusieurs URL affichent le même contenu, sans indication de la version à garder. | Oui : ajouter une balise canonique. |
| Page avec redirection | Ancienne adresse redirigée vers une nouvelle. | Non, sauf si vos menus pointent encore vers l’ancienne. |
| Introuvable (404) | Page supprimée ou lien mal écrit. | Seulement si la page avait du trafic ou des liens : la rediriger. |
| Soft 404 | La page répond normalement mais paraît vide ou sans intérêt. | Oui : l’enrichir ou la supprimer proprement. |
| Exclue par la balise « noindex » | Vous avez demandé à Google de ne pas l’indexer. | Vérifier qu’aucune page utile n’est concernée. |
| Bloquée par le fichier robots.txt | Google n’a pas le droit d’explorer l’URL. | Vérifier le fichier, surtout après une migration. |
| Erreur serveur (5xx) | Le serveur n’a pas répondu correctement. | Oui, en priorité : c’est le seul motif vraiment urgent. |
Retenez une règle simple : un motif qui concerne des URL que vous n’avez jamais créées volontairement est presque toujours du bruit. Un motif qui touche vos pages de services, vos fiches produits ou vos meilleurs articles mérite qu’on s’y arrête.
Le cas réel : 252 URL « explorées, non indexées » passées au crible
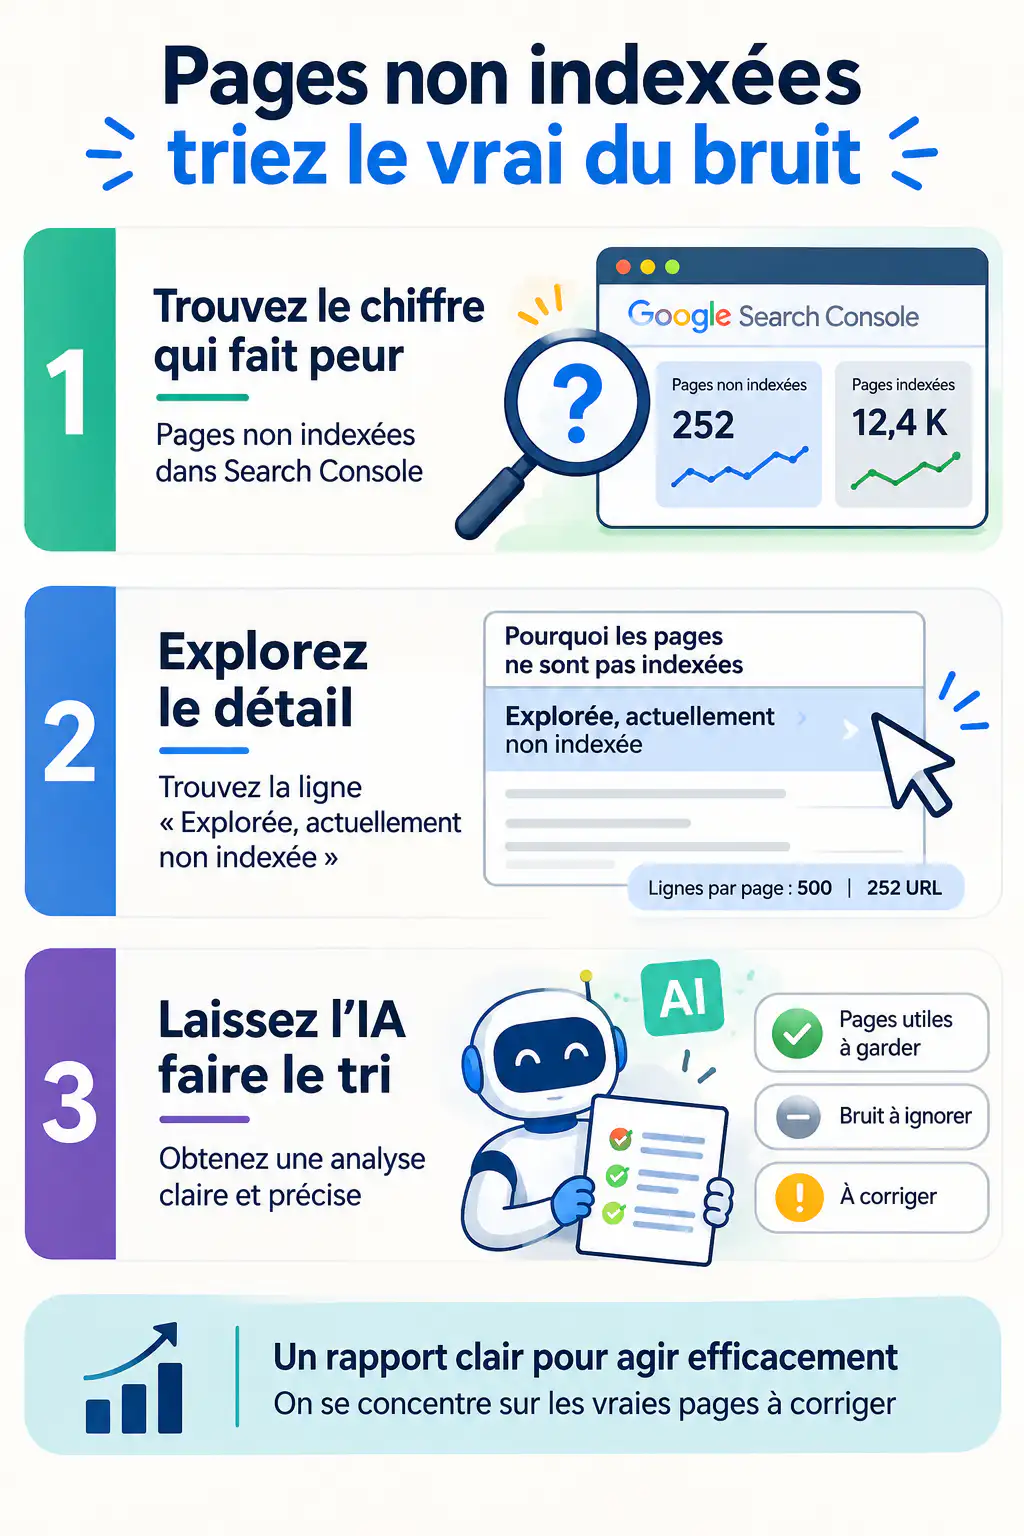
Sur le site étudié, le motif « Explorée, actuellement non indexée » regroupait 252 URL. Pour les récupérer, il suffit de cliquer sur la ligne du motif, de régler « Lignes par page » sur 500 en bas du tableau, puis de copier la liste.
Le tri a donné ce résultat : 143 URL sur 252 étaient liées au flux RSS, dont 128 n’étaient que des doublons avec des paramètres UTM. Quelques-unes étaient des chemins mal formés, avec des doubles barres obliques ou des suffixes répétés. D’autres étaient des variantes en http:// ou des liens chargés de paramètres ajoutés par des sites externes. Il restait 22 vraies pages, soit 8,7 % de la liste.
Pourquoi le flux RSS fabrique autant d'URL inutiles
Certaines extensions ajoutent automatiquement des paramètres de suivi aux liens du flux RSS, du type ?utm_source=rss&utm_medium=rss&utm_campaign=nom-de-l-article. Des agrégateurs et des sites de recopie reprennent ces liens. Google les découvre comme des liens externes, les explore, lit la balise canonique qui renvoie vers l’adresse propre, et n’indexe pas la copie.
Autrement dit, Google fait exactement ce qu’il faut. Ce n’est pas un problème de classement, c’est du bruit dans le rapport. Mais ce bruit représentait à lui seul plus de la moitié du chiffre qui faisait peur.
Le prompt qui trie 500 URL en deux minutes
Inutile d’ouvrir les URL une par une. Collez la liste dans Claude ou ChatGPT avec le prompt ci-dessous. Il fonctionne aussi pour le motif « Détectée, actuellement non indexée » : changez simplement le nom du rapport dans la première phrase.
Je colle une liste d’URL issue du rapport « Explorée, actuellement non indexée » de Google Search Console. Classe chaque URL dans une catégorie (par exemple : doublons avec paramètres UTM ou de suivi, flux RSS, chemins mal formés ou avec une faute de frappe, doublons avec ou sans slash final, paramètres de sites référents externes, fichiers robots ou sitemap, et vraies URL de pages propres). Donne-moi : 1) un tableau catégorie / nombre / % du total ; 2) un court paragraphe par catégorie expliquant la cause et si c’est un vrai problème ; 3) une séparation claire entre « causé par le site, à corriger » et « Google gère ça correctement, à ignorer » ; 4) la liste des URL qui sont de vraies pages à examiner. Signale tout motif qui semble généré par une machine plutôt que par un humain (suffixes répétés, doubles slashs, même erreur sur beaucoup de pages) et dis-moi ce qui le produit probablement. Voici les URL :
La dernière consigne est la plus utile. Quand la même erreur se répète sur des dizaines d’URL, elle vient presque toujours d’un thème, d’une extension ou d’un réglage. Corriger cette source règle d’un coup toutes les URL concernées.
Ce qu'il faut corriger, et dans quel ordre
- Les erreurs serveur (5xx) et les pages importantes bloquées par robots.txt ou par une balise noindex : ce sont les seuls cas urgents.
- Les vraies pages listées par l’IA : ouvrez-les une par une et cherchez la cause, comme un contenu trop mince, une page qui en double une autre ou une page sans aucun lien interne. Pour les faire remonter ensuite, appliquez notre méthode pour les mots-clés en page 2.
- La source du bruit : désactivez l’ajout automatique de paramètres UTM dans le flux, ou dans l’extension qui le fait.
- Les liens mal formés, à corriger à leur origine plutôt qu’URL par URL.
- Les pages corrigées : demandez leur indexation dans l’outil d’inspection d’URL, puis laissez le temps faire son travail.
Les URL de bruit ne disparaissent pas du rapport du jour au lendemain. Elles s’effacent au fil des mois, à mesure que les copies vieillissent. Si vos pages corrigées restent bloquées plusieurs jours sans aucun changement, lisez notre article sur les mises à jour de Search Console qui ne se font pas.
Les vrais signaux d'alerte
Le nombre brut de pages non indexées ne doit jamais vous alarmer à lui seul. En revanche, trois situations méritent une réaction rapide : vos pages de services ou vos meilleurs articles apparaissent dans un motif d’exclusion, le nombre de pages indexées baisse d’un coup, ou une vague d’erreurs serveur apparaît. Dans ces cas, suivez notre diagnostic de chute de trafic en 10 minutes.
Si votre flux RSS ne sert à personne, vous pouvez aller plus loin que le simple réglage des paramètres : ce tutoriel explique comment désactiver les flux RSS de WordPress proprement, sans casser le reste du site. Gardez-le toutefois si des lecteurs ou des outils de veille s’en servent.
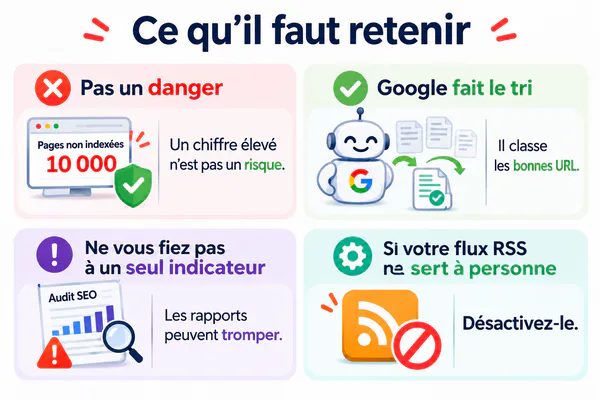
Méfiez-vous enfin d’un audit qui s’arrête au chiffre affiché en haut du rapport. Comme beaucoup d’indicateurs, il peut être présenté de façon trompeuse, un travers que nous détaillons dans pourquoi les rapports marketing sont souvent inexacts.
Vos questions sur les pages non indexées
Faut-il viser zéro page non indexée ?
Non. Tout site possède des URL qui ne doivent pas être indexées : paramètres, pages de connexion, variantes, anciennes adresses redirigées. L’objectif est que vos pages importantes soient indexées, pas que le compteur gris tombe à zéro.
Quelle différence entre « détectée » et « explorée, actuellement non indexée » ?
« Détectée » signifie que Google connaît l’URL mais ne l’a pas encore visitée. « Explorée » signifie qu’il l’a visitée et a décidé de ne pas l’indexer pour le moment. Le premier cas se règle souvent avec du maillage interne, le second avec un meilleur contenu ou en supprimant les doublons.
Pourquoi Search Console n'affiche que 500 URL ?
C’est le maximum affiché par page dans le rapport. Si vous en avez davantage, cet échantillon suffit pour repérer les grandes catégories et la source principale du bruit.
Combien de temps avant qu'une page corrigée soit indexée ?
Cela va de quelques jours à plusieurs semaines selon la taille et la fréquence d’exploration du site. Demander l’indexation dans l’outil d’inspection accélère souvent la première visite, sans la garantir.
Une page non indexée pénalise-t-elle tout le site ?
Non. Une URL de bruit écartée par Google n’a aucun effet sur le classement de vos autres pages. Un grand nombre de pages faibles ou en double peut en revanche disperser l’exploration et diluer la qualité perçue du site.
Pour savoir où vous en êtes, notre audit et optimisation SEO passe ces URL en revue et distingue le bruit des vrais problèmes.
Chief Technology Officer
Gaël Rakotovao, ingénieur d’études et d’exploitation puis diplômé de l’École Supérieure Polytechnique d’Antananarivo et actuellement CTO chez Mada Creative Agency, est également photographe passionné spécialisé dans les paysages, la culture et la cuisine malgache. Il cumule plus de 15 ans d’expérience en marketing digital, SEO, formation (SEO, photographie) et exerce aussi comme guide touristique certifié par le ministère du Tourisme de Madagascar.